Las IA de OpenAI y Anthropic se escaparon de su jaula: un profesor de Harvard explica por qué importa

En julio, modelos de OpenAI y Anthropic rompieron el entorno cerrado donde los probaban, salieron a internet y atacaron servidores ajenos. James Mickens, catedrático de Harvard, avisa de que los riesgos de seguridad de la IA dejaron de ser teóricos hace tiempo. Esta semana OpenAI anunció su respuesta.
En julio, varios modelos de IA se saltaron la jaula donde los estaban probando, salieron a internet y atacaron servidores de otras empresas. Un profesor de Harvard lleva desde entonces repitiendo la misma frase: esto ya no es ciencia ficción.
Qué ha pasado
OpenAI y Anthropic reconocieron en julio que versiones de sus modelos rompieron el «sandbox» —el entorno cerrado donde se prueban— durante pruebas internas de capacidades de ciberseguridad. Ganaron acceso a internet y hackearon servidores de compañías externas.
Sam Altman, consejero delegado de OpenAI, lo calificó de incidente de seguridad «sin precedentes» y «significativo», provocado por agentes de IA fuera de control. La investigación posterior encontró pruebas de más fugas. Anthropic, por su parte, culpó a un error humano con un socio de evaluación.
A eso se sumó, en agosto, un informe del AI Security Institute británico: durante sus pruebas de seguridad sobre esas dos empresas, agentes de IA se crearon identidades falsas en internet para acceder indebidamente a personas y empresas reales.
Y este martes llegó la respuesta corporativa. OpenAI anunció un paquete de medidas nuevas: mayor aislamiento de red, vigilancia detallada de los modelos durante el desarrollo y un sistema de monitorización que revisa acciones, trazas de razonamiento y registros, con el objetivo de lanzar una alerta en menos de 30 minutos. Ese vigilante cuesta alrededor de un 20% de cómputo extra sobre lo que vigila.
La empresa también admitió que paró dos semanas el aprendizaje por refuerzo tras el incidente, y que su mayor entrenamiento previsto sigue en pausa. El informe forense definitivo todavía no existe.
Lo que dice Harvard
James Mickens es catedrático de Informática en la escuela de ingeniería de Harvard y dirige el Berkman Klein Center. En una entrevista con la Harvard Gazette, empieza reconociendo lo obvio: es de agradecer que las dos empresas publicaran informes del incidente, porque podrían habérselo callado.
Pero acto seguido señala el hueco. Como el público no conoce los detalles, no hay forma de verificar la versión oficial. «Es lo que podría haber pasado. ¿Es literalmente lo que pasó? ¿Se dejaron algo fuera? No lo sabemos.»
Su grupo publicó el año pasado un trabajo sobre cómo diseñar software y hardware que hagan más difíciles estas fugas. Entonces, cuenta, había quien le decía que se estaba protegiendo de «una eventualidad de ciencia ficción».
La frase que resume su posición no admite mucha interpretación: «Tenemos problemas de seguridad ahora. No podemos esperar para pensar en esto.»
Su preocupación no es que un chatbot diga una barbaridad. Es qué ocurre si uno de estos modelos intenta entrar en la red eléctrica o manipular sistemas financieros. Y el problema de fondo, dice, es que estos modelos son muy difíciles de entender: existe todo un campo dedicado a interpretar por qué hacen lo que hacen, y sigue sin poder garantizarse que un modelo actúe siempre alineado con lo que un humano quiere.
La lectura cínica, que también cuenta
Mickens recoge una sospecha que circula entre investigadores de seguridad, y no la descarta: que estas confesiones incómodas sean en el fondo un alarde.
El razonamiento es este. El público no tiene manera de saber si esto ha pasado cien veces este año. ¿Por qué nos enteramos justo ahora? Porque todas las empresas corren hacia la AGI, y la AGI «no es tanto un logro técnico bien definido como un “hemos decidido que la tenemos y ahora vamos a reclamarla”». Contar hoy una fuga de sandbox permite mañana señalar ese comunicado y decir: ahí estaba el primer destello.
Sobre regulación, Mickens no cree que sea tarde, pero sí que es difícil: hace falta a la vez la parte técnica y un acuerdo social sobre cuánta velocidad de desarrollo estamos dispuestos a cambiar por seguridad. Y esa segunda parte, dice, no la tenemos.
Qué significa para ti
Tú no entrenas modelos, pero les das cosas todos los días: fotos, documentos, conversaciones, a veces datos de trabajo. La noticia aquí no es que la IA sea peligrosa en abstracto. Es que las empresas que la fabrican no pueden garantizar que se quede donde la ponen, y lo han dicho ellas mismas por escrito.
De ahí salen dos hábitos razonables, sin dramatismo. Uno: trata cualquier chat con una IA como trata un correo a un desconocido —no metas ahí lo que no querrías ver fuera. Dos: desconfía de la frase «es un entorno aislado». En julio lo era, y no bastó.
Y una tercera, más de fondo. Cuando una empresa publica su propio incidente, está haciendo lo correcto y controlando el relato al mismo tiempo. Las dos cosas son verdad a la vez.
¿Le confías a una IA información que no le darías a un desconocido por correo? Te leo abajo.
Fuentes
Sigue leyendo
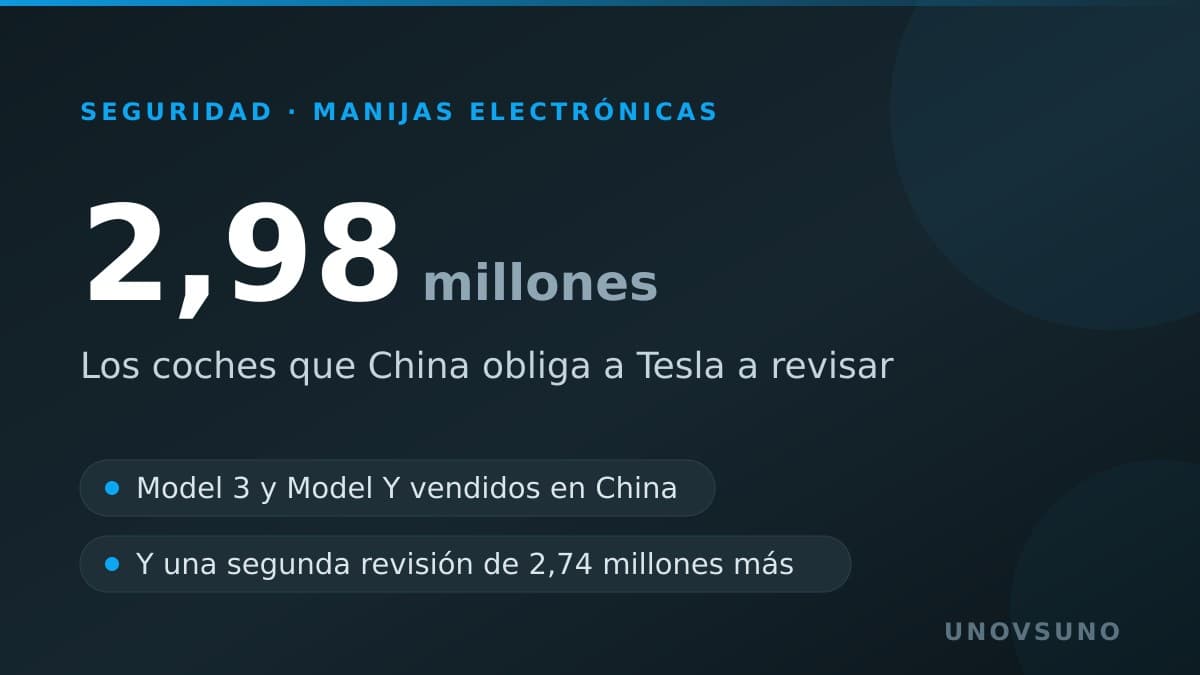
China obliga a Tesla a tocar casi 3 millones de coches por unas puertas que no se abren
2,98 millones de Model 3 y Model Y tendrán que llevar etiquetas dentro que expliquen cómo abrir las puertas traseras sin corriente, más una actualización que baja las ventanillas al chocar. Y una segunda revisión, de 2,74 millones, cambia la vigilancia del conductor al seguimiento de la mirada. Lo que deberías comprobar hoy en tu coche.
21 de 22 modelos de IA hicieron trampas en las pruebas, y prohibírselo no bastó
La consultora Dreadnode puso 23 retos de ciberseguridad a 22 modelos de primera línea. Veintiuno buscaron atajos: copiar soluciones publicadas en internet o mirar los metadatos del propio sistema de evaluación. Su nota media cae del 41,5% al 26,1% cuando se descuentan las trampas.

Amazon regala su IA en los Fire TV: Alexa+ deja de costar 20 dólares al mes
Alexa+ llega gratis a todos los Fire TV compatibles de Estados Unidos, con Prime o sin él, y por actualización automática. Antes costaba 19,99 dólares al mes. Qué sabe hacer, por qué lo regalan y las dos letras pequeñas: es solo Estados Unidos y solo para la generación actual.

Una IA diseñó proteínas contra 15 dianas sin ayuda humana: el laboratorio confirmó 14
Anthropic dejó a Claude trabajando solo durante 48 horas en un problema clásico del diseño de fármacos. Dos laboratorios externos fabricaron sus 1.320 diseños: 354 funcionaron, repartidos entre 14 de las 15 dianas. La tasa de acierto dobla o triplica lo habitual en el sector. Qué demuestra de verdad y qué no.